NVIDIA chce połączyć 576 GPU w jeden ogromny system. Wydajność będzie absurdalna


NVIDIA szykuje kolejny gigantyczny skok w skalowaniu akceleratorów AI. Vera Rubin Ultra NVL576 połączy aż 576 GPU w jednej domenie NVLink, dzięki czemu cały zestaw będzie mógł pracować jak jeden ogromny akcelerator. Żeby było to w ogóle możliwe, firma musi jednak częściowo porzucić klasyczne przewody miedziane i przejść na połączenia optyczne.
Nowe szczegóły przedstawił Ian Buck, wiceprezes NVIDIA odpowiedzialny za systemy hyperscale i HPC. Rubin Ultra NVL576 ma połączyć osiem oddzielnych szaf serwerowych, z których każda zawiera 72 GPU, tworząc jedną domenę obejmującą 576 akceleratorów. To ważne doprecyzowanie, bo określenie „jeden gigantyczny GPU” może być trochę mylące. Nie powstaje jeden fizyczny układ krzemowy zawierający 576 GPU. NVIDIA chce natomiast sprawić, żeby z punktu widzenia komunikacji między akceleratorami cały zestaw zachowywał się jak jeden potężny system obliczeniowy.
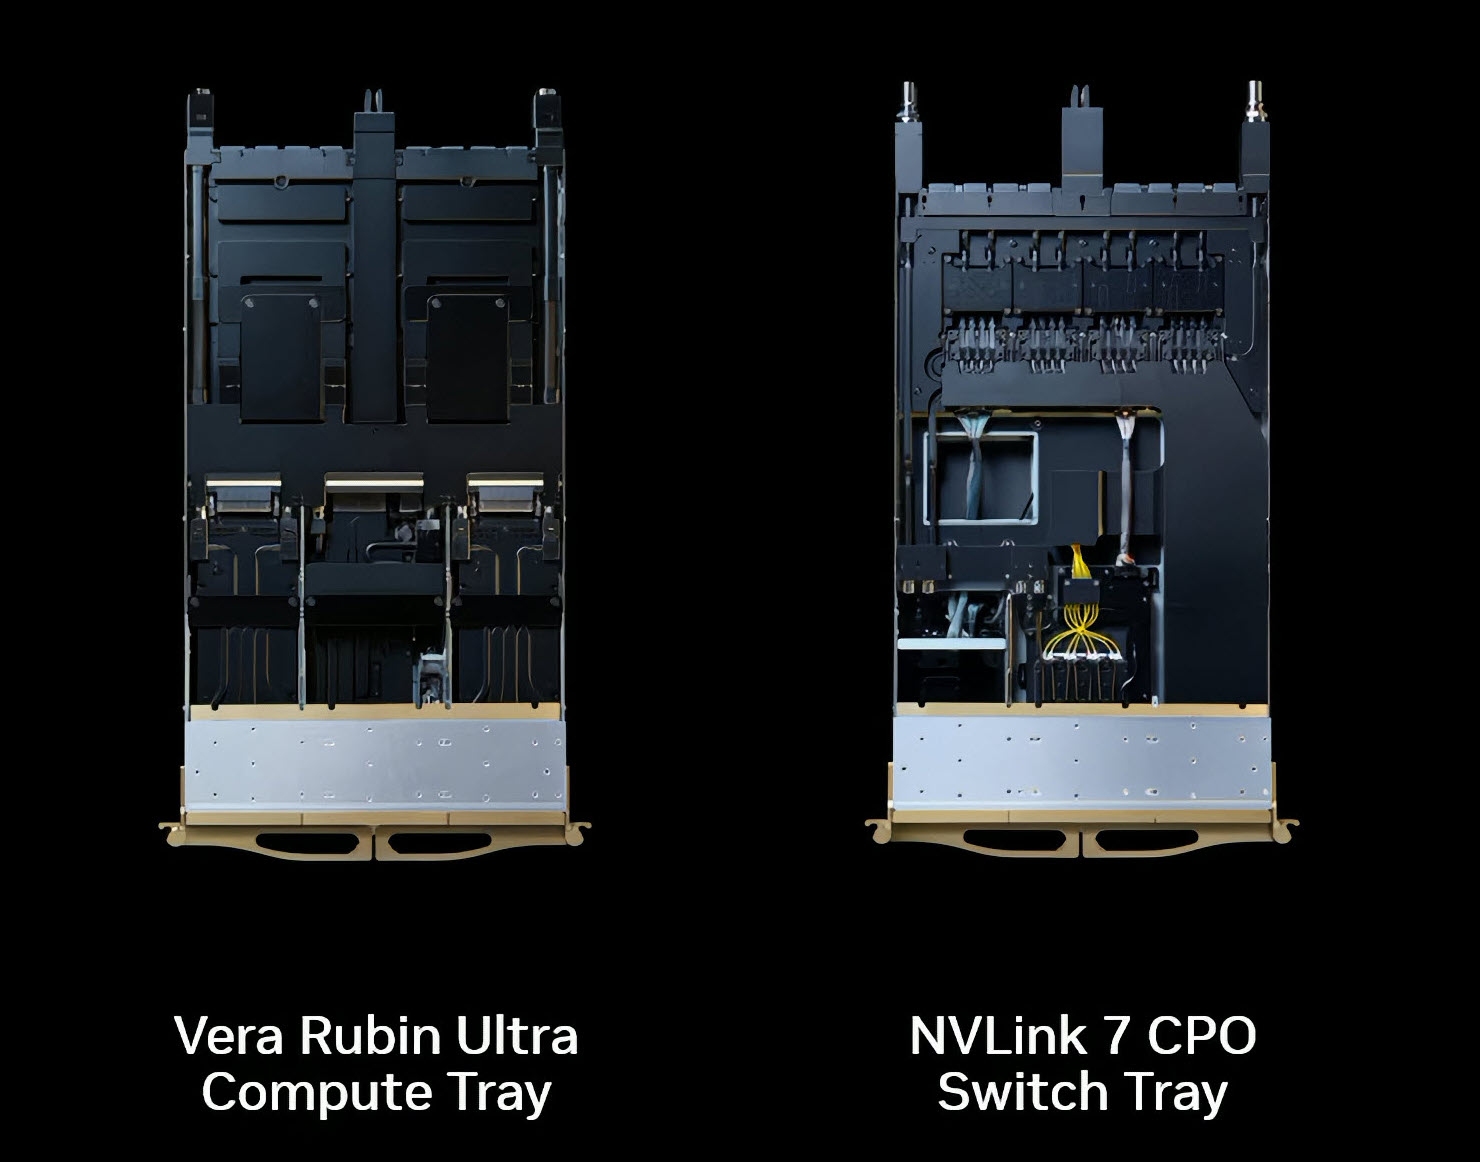
Kluczową rolę odegra tutaj NVLink oraz CPO, czyli optyka zintegrowana bezpośrednio z układem przełączającym. W tradycyjnych systemach sygnał pomiędzy szafami musi przechodzić przez miedziane przewody oraz kolejne układy wzmacniające i regenerujące sygnał. Przy takich odległościach i przepustowościach zaczyna to pochłaniać ogromne ilości energii. Połączenia optyczne pozwalają przesyłać dane pomiędzy szafami znacznie dalej przy mniejszych stratach i mniejszym zużyciu energii. To właśnie dlatego NVIDIA rozwija NVLink CPO Switch Tray, w którym elementy optyczne znajdują się bardzo blisko samego układu sieciowego. Firma chce dzięki temu ograniczyć liczbę klasycznych transceiverów i zostawić większą część budżetu energetycznego centrum danych na właściwe obliczenia.
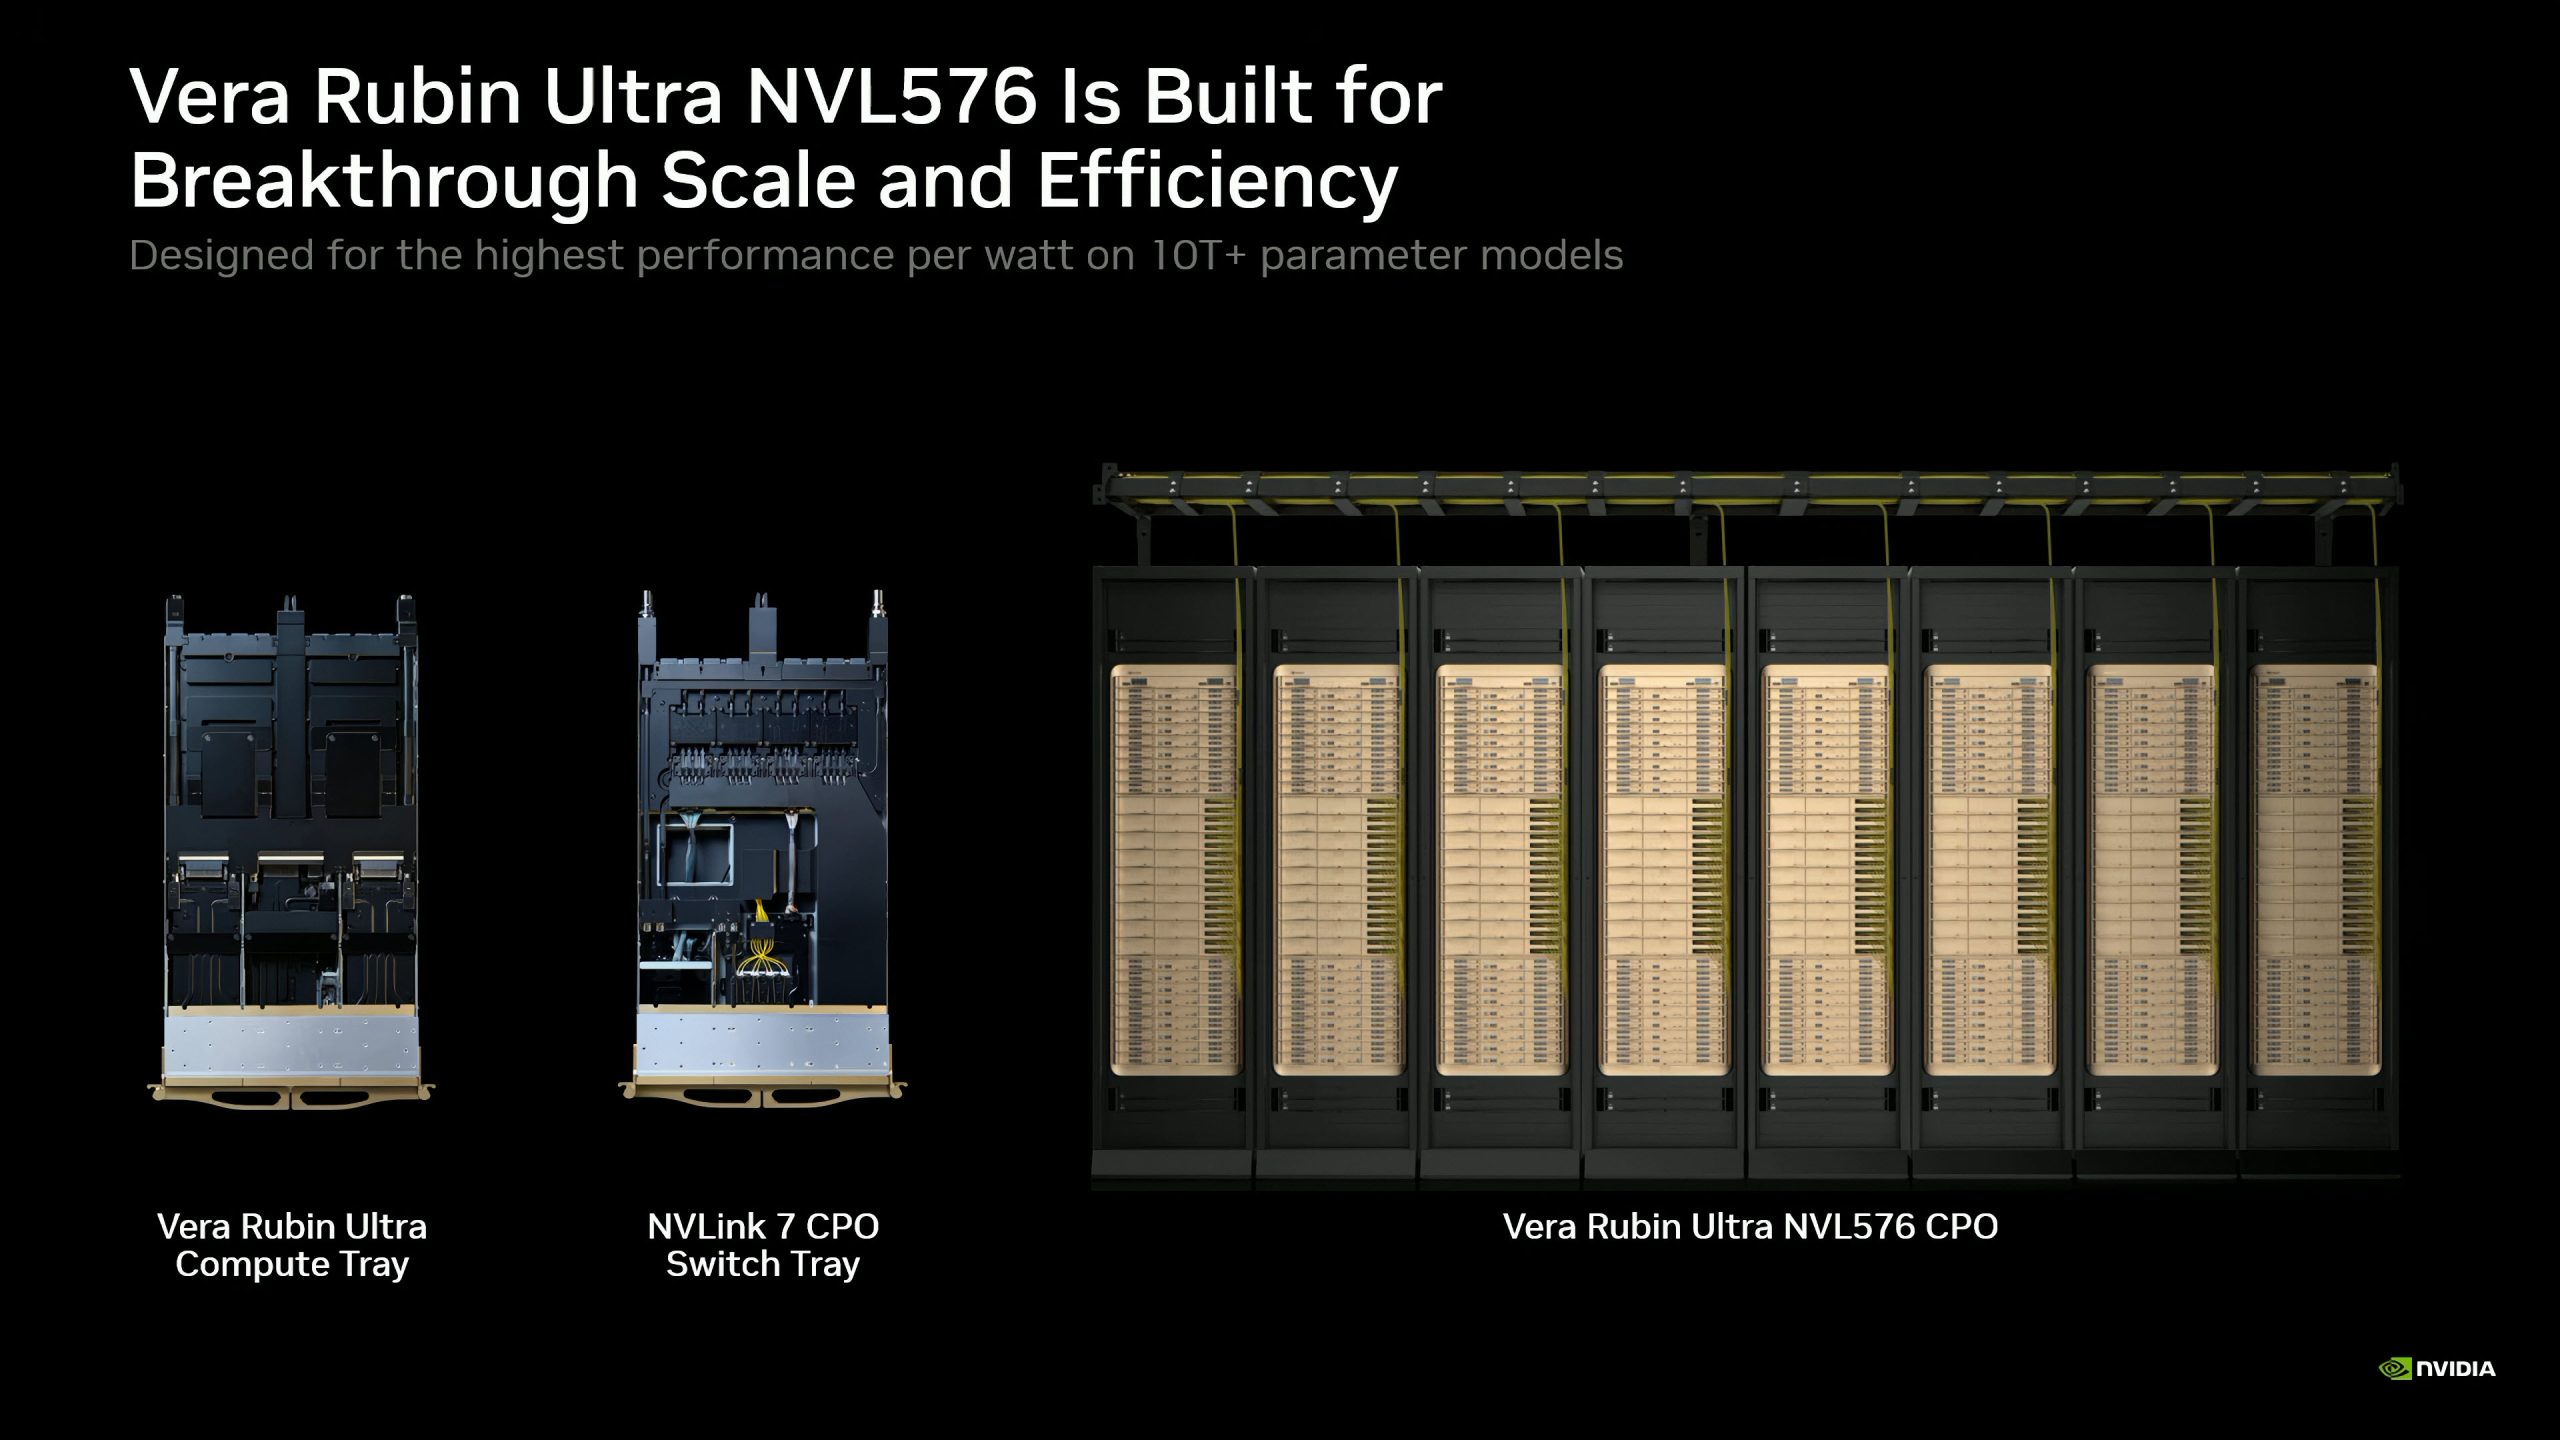

NVIDIA mówi wprost, że przy systemie obejmującym 576 GPU sama miedź przestaje być praktycznym rozwiązaniem do komunikacji między szafami. Wewnątrz pojedynczej szafy nadal może być wykorzystywana, ale dłuższe połączenia będą realizowane optycznie. Skala robi się przy tym absurdalna. Obecny Vera Rubin NVL72 łączy 72 GPU i zapewnia około 260 TB/s łącznej przepustowości NVLink wewnątrz pojedynczej szafy. Rubin Ultra NVL576 rozszerzy tę koncepcję na osiem szaf połączonych dwuwarstwową topologią all-to-all.
Według NVIDIA cały system ma być przygotowany między innymi do pracy z modelami mającymi około 10 bilionów parametrów. Ian Buck określił konstrukcję jako NVLink „giant GPU” o najwyższej wydajności na wat, jaką firma zamierza dotychczas zaoferować. To oczywiście deklaracja producenta, której na tym etapie nie da się jeszcze niezależnie zweryfikować. Sam Rubin Ultra będzie również znacznie większym układem niż obecny Rubin. Pojedynczy akcelerator skorzysta z bardzo dużej ilości pamięci HBM4E, a pełna platforma NVL576 ma oferować moc liczoną już w wielu eksaflopach dla obliczeń AI. Najważniejsze nie jest jednak samo dorzucenie kolejnych GPU, lecz umożliwienie im wystarczająco szybkiej komunikacji.
NVIDIA pokazała już działający prototyp takiej wieloszafowej architektury. System o nazwie Polyphe, zbudowany jeszcze na GB200, służy firmie do testowania koncepcji NVL576 i połączenia ośmiu szaf w jedną domenę NVLink. To oznacza, że rozwiązanie nie istnieje wyłącznie na slajdach. A NVIDIA planuje pójść jeszcze dalej. Następna architektura szaf Kyber ma mieścić po 144 GPU, a osiem takich konstrukcji będzie można połączyć w system NVL1152 obejmujący aż 1152 akceleratorów. To właśnie wtedy połączenia optyczne staną się jeszcze ważniejsze.